Indsigt · ca. 18 min. læsning
OmJev · TypeSafeVores egen test, ikke et samarbejde med TypeSafe
Jev fra TypeSafe testet på dansk: hvad den kan og hvor den gætter
Jev er en ny slags AI-model, der vælger i stedet for at skrive. Her er vores test på dansk, hvor vi bruger den internt, og hvad vi ikke har prøvet.
Jev er en ny AI-model fra TypeSafe, som ikke skriver tekst. Jeres kode stiller faste spørgsmål om en tekst, og Jev svarer med sandsynligheder for de svar, I har tilladt. I en lille test med 24 danske henvendelser, vi selv havde skrevet, satte den alle i den rigtige kategori, og et kald tog typisk godt et kvart sekund. Mod Claude Haiku 5.5 og GPT-6 Luna svarede den i median 5 til 10 gange hurtigere i vores test 10. oktober 2026, men den ramte ikke oftere rigtigt. Når svaret ikke står i teksten, gætter den, og data behandles i USA. I testen passede den til en første sortering, hvor et menneske eller jeres kode træffer afgørelsen. Rigtige kundehenvendelser har vi ikke prøvet den på.
| Emne | Kort fortalt |
|---|---|
| Hvad | En AI-model, der vælger mellem svar, I selv har bestemt, og ikke skriver tekst. |
| Prøvet til | Første sortering af beskeder i en lille test: emne, hastegrad, sælger eller kunde. |
| Kræver | En udvikler, der kobler den på jeres system og bestemmer, hvornår et menneske tager over. |
| Pris | 0,042 USD pr. million input-tokens (tekststykker) ifølge TypeSafe. En lav pris pr. kald er ikke en besparelse for hele løsningen. |
| Svartid | Typisk godt et kvart sekund fra vores server. Enkelte kald tog flere sekunder. |
| Dansk | 24 af 24 rigtige kategorier i vores lille test, men ifølge TypeSafe er modellen stærkest på engelsk. |
| Mod sprogmodeller | Kortere svartid end Claude Haiku 5.5 og GPT-6 Luna i vores test 10. oktober 2026, men ikke flere rigtige svar. Se benchmarken. |
| Data | Teksten sendes til USA. At den ikke gemmes, kræver en aftale eller opsætning. |
Hvad er Jev og hvordan adskiller den sig fra en sprogmodel?
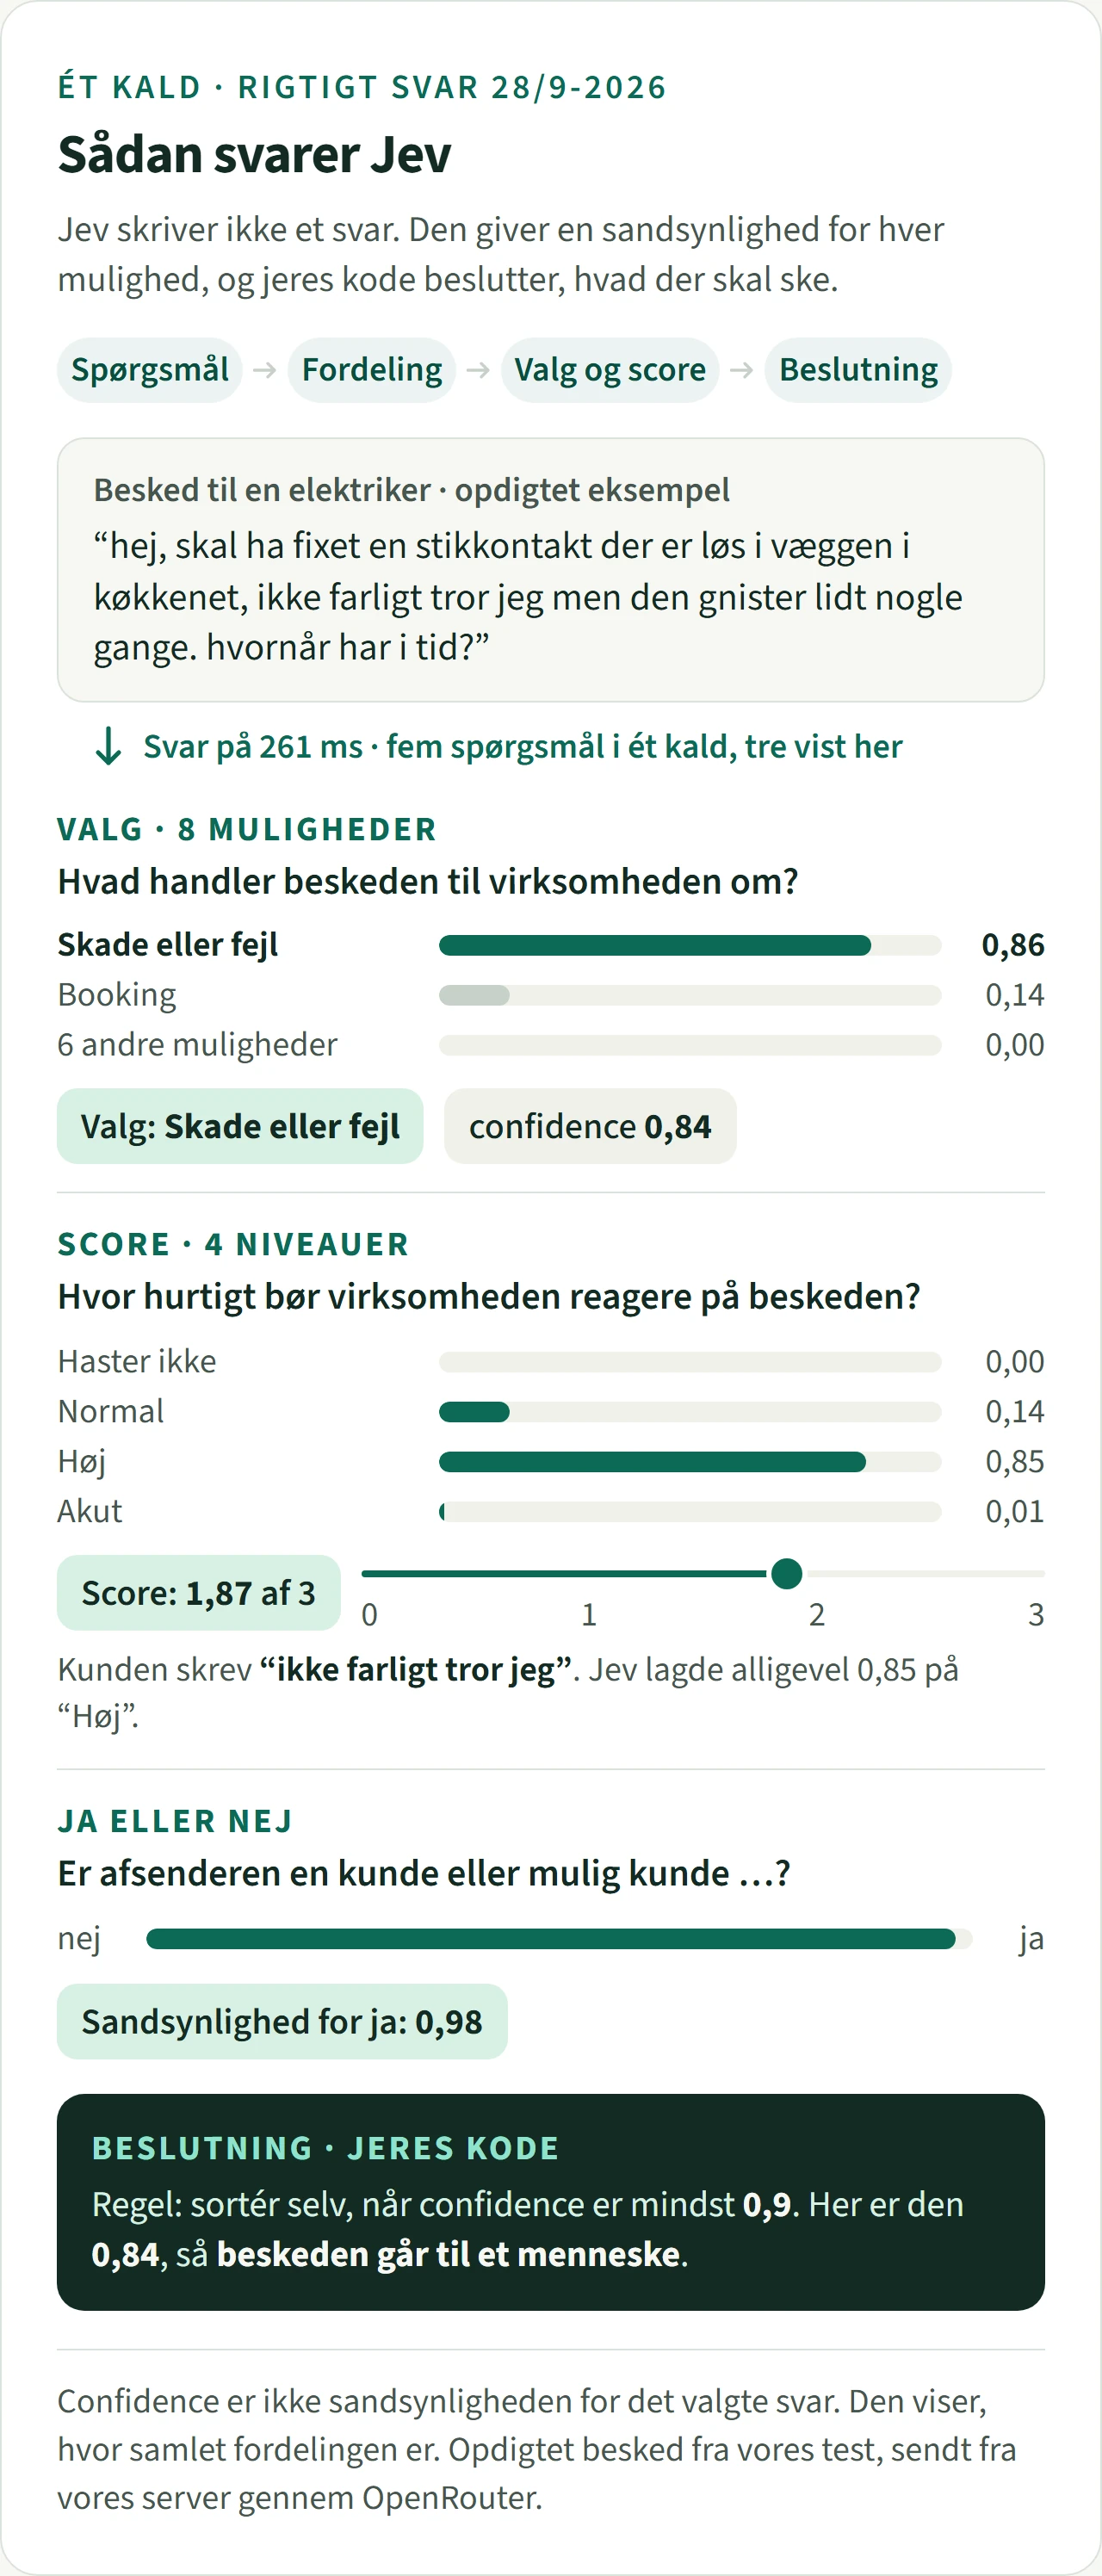
ChatGPT og lignende sprogmodeller skriver et svar i tekst, som koden bagefter skal fortolke. Jev er bygget omvendt. Koden sender en tekst og en række spørgsmål med de tilladte svar, og Jev svarer med sandsynligheder for dem og ved vælg-en også med selve valget. Alle spørgsmål i et kald besvares på en gang og uafhængigt af hinanden.
TypeSafe er stiftet af den tidligere OpenAI-forsker Diogo Almeida og lancerede Jev 15. september 2026 sammen med en finansiering på 40 mio. USD. Modeltypen hedder System One efter Kahnemans begreb om den hurtige, intuitive tænkning. Ifølge TypeSafe bliver Jev ikke trænet på jeres data. Man styrer den med teksten og med korte beskrivelser af hvert svar.
Efter den første uges test og interne brug var vores tommelfingerregel: Koden beregner, Jev vurderer, og sprogmodellen skriver.
Hvordan virker Jev og hvilke svar kan den give?
| Svarform | Eksempel | Det får I tilbage |
|---|---|---|
| Ja/nej | Vil afsenderen sælge noget til os? | En sandsynlighed for ja mellem 0 og 1. |
| Vælg en | Hvad handler beskeden om? Op til 255 muligheder. | Valget, en sandsynlighed for hver mulighed og en confidence. |
| Skala | Hvor hurtigt skal vi reagere? 2 til 10 trin. | En score på skalaen, en sandsynlighed for hvert trin og en confidence. |
Confidence er et ekstra tal ved vælg-en og skala, som ifølge Vercels guide (åbner i ny fane) måler, hvor samlet fordelingen er: 0, når den er spredt jævnt ud, og 1, når alt ligger på en mulighed. TypeSafes egen side om confidence (åbner i ny fane) beskriver det også som et mål afledt af svarfordelingen. Det er ikke en kalibreret sandsynlighed for, at svaret er rigtigt, og 0,8 betyder ikke 80 procent chance for et rigtigt svar. Ja/nej-svar har ingen confidence. Vi bruger tallet til at afgøre, om koden må handle selv, men en grænse skal efterprøves på den konkrete opgave. Jev tager kun tekst ind, så billeder og lyd kan den ikke bruge, og den skriver hverken svar eller begrundelser.
Forslag til hvor Jev sidder i systemet
- En henvendelse kommer indEn mail, en formular eller et opkald, der er skrevet ud.
- Koden sender kun det nødvendigeNavn, telefon, mail og adresse tages ud. Teksten er dataminimeret, ikke anonym.
- Jev vurdererVia en mellemmand som OpenRouter eller Vercel. Svaret er sandsynligheder for de tilladte svar.
- Koden tjekker svaretDen rigtige modelversion skal have svaret, og fordelingen skal være hel.
- Grænsen afgørOver grænsen handler koden. Under den ser et menneske sagen. Ved fejl eller timeout gælder den gamle adfærd.
Hvad kan en dansk virksomhed bruge Jev til?
To af anvendelserne kører i drift hos os: forslag efter opkald på vores egne Ringback-linjer og kontrollen i vores ugentlige AI-svarmåling. Sortering af henvendelser, leads og driftshændelser har vi kun testet på beskeder og hændelser, vi selv har skrevet, og videresendelse slet ikke.
Sortering af henvendelser
Hvad handler beskeden om, hvor meget haster den, og er det en sælger? I vores test gav gaslugt i opgangen 2,99 på en skala fra 0 til 3. En ironisk klage (”Tusind tak for den fantastiske service … fjerde gang, jeg skriver”) blev genkendt som reklamation med 0,86, og en SEO-sælger som salg med 0,99.
Forslag efter et opkald
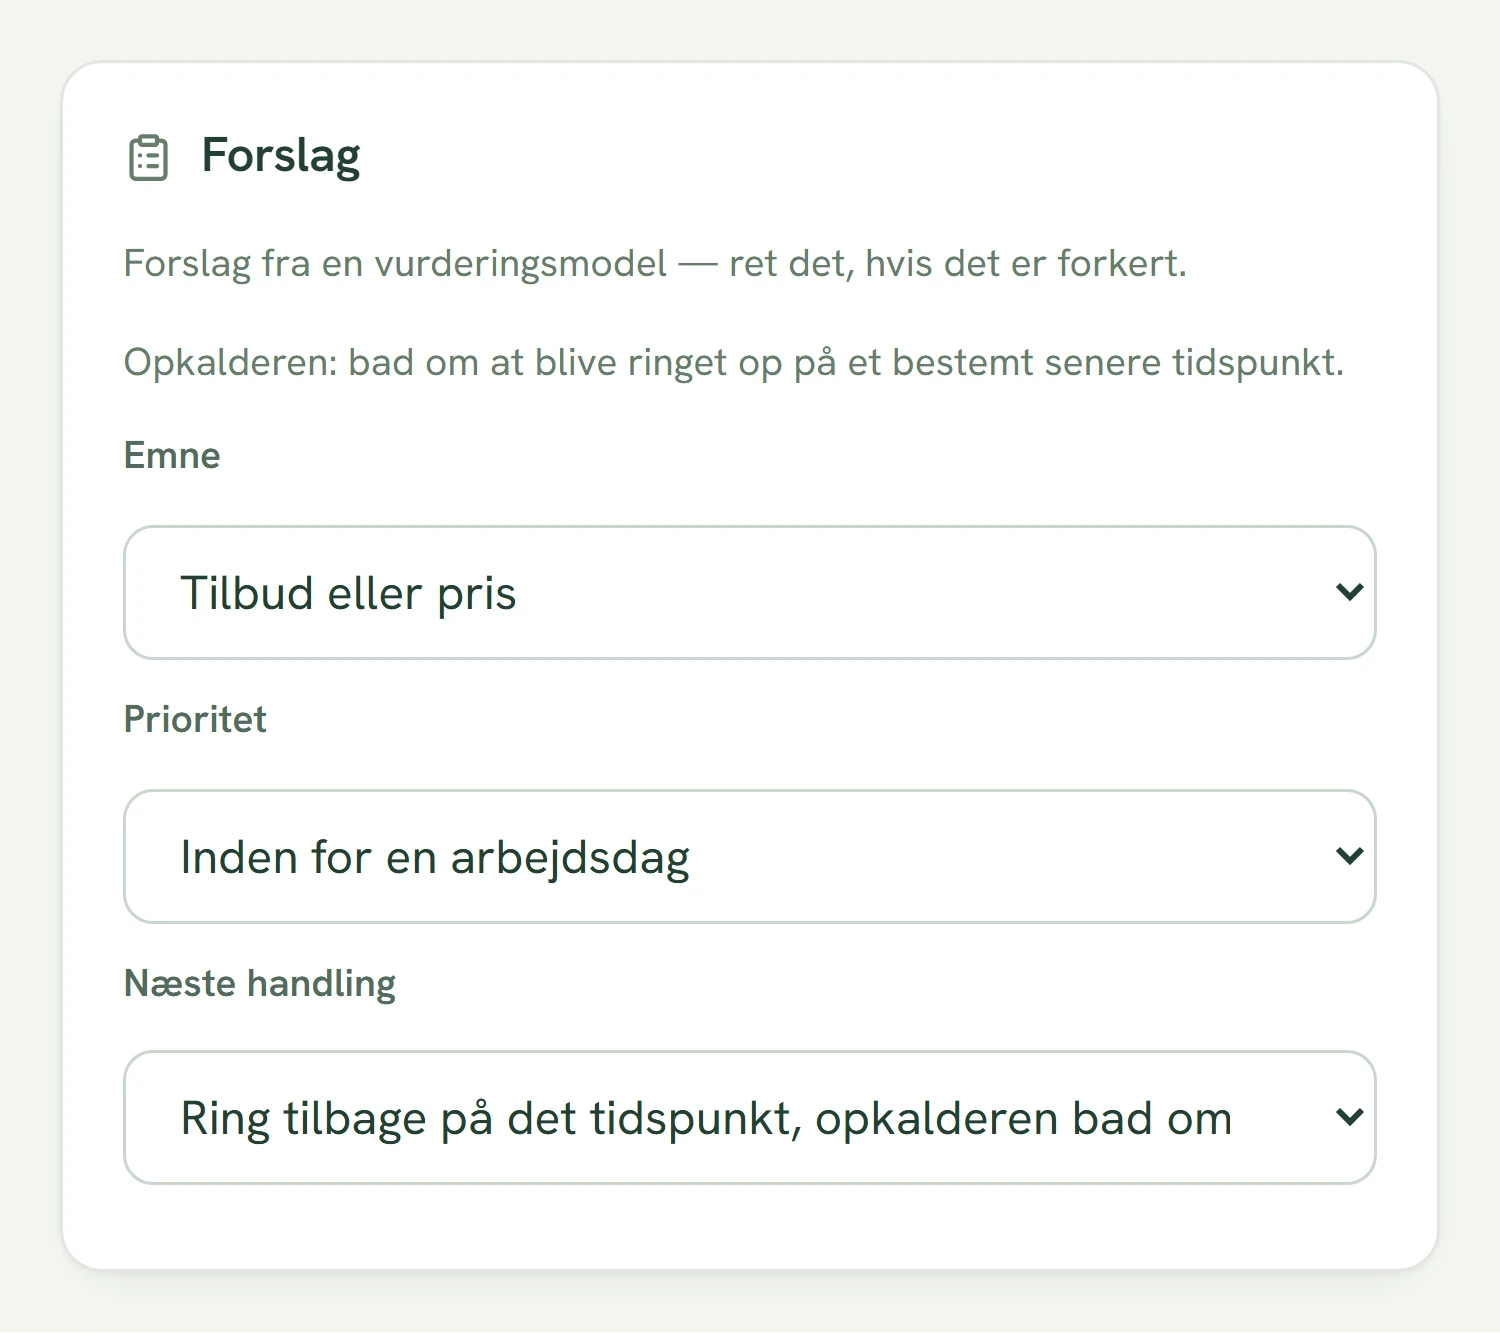
I Ringback, vores egen telefonpasning, foreslår Jev efter et opkald emne, prioritet, opkalderens eget ønske og næste handling. Brugeren kan rette forslaget, og rettelsen gælder altid. På 30 opdigtede opkald steg den rigtige næste handling fra 22 til 30, da vi tilføjede et spørgsmål om opkalderens ønske og en regel i koden, der giver ønsket forrang. Vi rettede efter de samme 30, så tallet viser kun, at rettelsen virkede på dem. Funktionen kører i drift på husets seks interne konti, og 7 forslag på ni dage siger endnu intet om kvaliteten.
Kontrol af det en anden AI har skrevet
Hver mandag stiller vi 97 spørgsmål til ChatGPT og Perplexity og måler, om vores produkter bliver nævnt. Her kører Jev i drift og afgør, om et svar handler om vores produkt eller om en navnefælle som ringback.com. I evalueringen 20. september mod 88 svar, vi havde gennemgået i hånden, steg de rigtige domme fra 69 til 86, og 16 af de 17 rettelser kom fra Jev. Det koster 0,015 USD om ugen. I en dokumenttest 22. september fangede Jev også alle 24 indlagte fejl, men dagen før overså den en subtil fejl i et resume.
Leads og videresendelse
Passer henvendelsen til det, I sælger? I en prøve 20. september ramte Jev 5 af 5 opdigtede leads, for få til at konkludere. Samme mekanik kan sende en sag til den rette medarbejder, kø eller model, og OpenRouter viser siden 25. september en router, som ifølge OpenRouter kører på Jev. Den har vi ikke prøvet.
Hvad viser vores målinger på dansk?
Den 28. september skrev vi 24 henvendelser til danske småvirksomheder, fra VVS og el til revisor og frisør, med fem spørgsmål til hver, på dansk, på engelsk og blandet med dansk tekst og engelske spørgsmål. Facit blev låst før første kald, og alle 184 kald fra vores egen server gik igennem for 0,015 USD i alt.
| Udgave | Kategori | Hastegrad | Kunde | Afsendertype | Samlet |
|---|---|---|---|---|---|
| Dansk | 24 af 24 | 22 af 24 | 23 af 23 | 19 af 24 | 88 af 95 |
| Engelsk | 24 af 24 | 22 af 24 | 23 af 23 | 21 af 24 | 90 af 95 |
| Blandet | 24 af 24 | 23 af 24 | 22 af 23 | 18 af 24 | 87 af 95 |
På de tydelige beskeder var dansk og engelsk lige gode, og Jev valgte samme kategori på begge sprog i alle 24. Hastegraden ramte inden for et halvt trin i 22 af 24, og en af de to fejl var en rekrutteringsmail, der fik 0,8 i stedet for 0. Afsendertypen gjorde vi med vilje svær, og uden den var 69 af 71 domme rigtige i alle tre udgaver. En besked havde intet entydigt facit om kunde. Dansk brugte 19 procent flere tokens end engelsk. Samme aften kørte vi de danske beskeder og 30 tekniske driftshændelser gennem to små sprogmodeller, og 10. oktober 2026 gentog vi målingen mod den nye Claude Haiku 5.5. Resultatet står i Jev mod Claude Haiku 5.5 og GPT-6 Luna.
Svartid
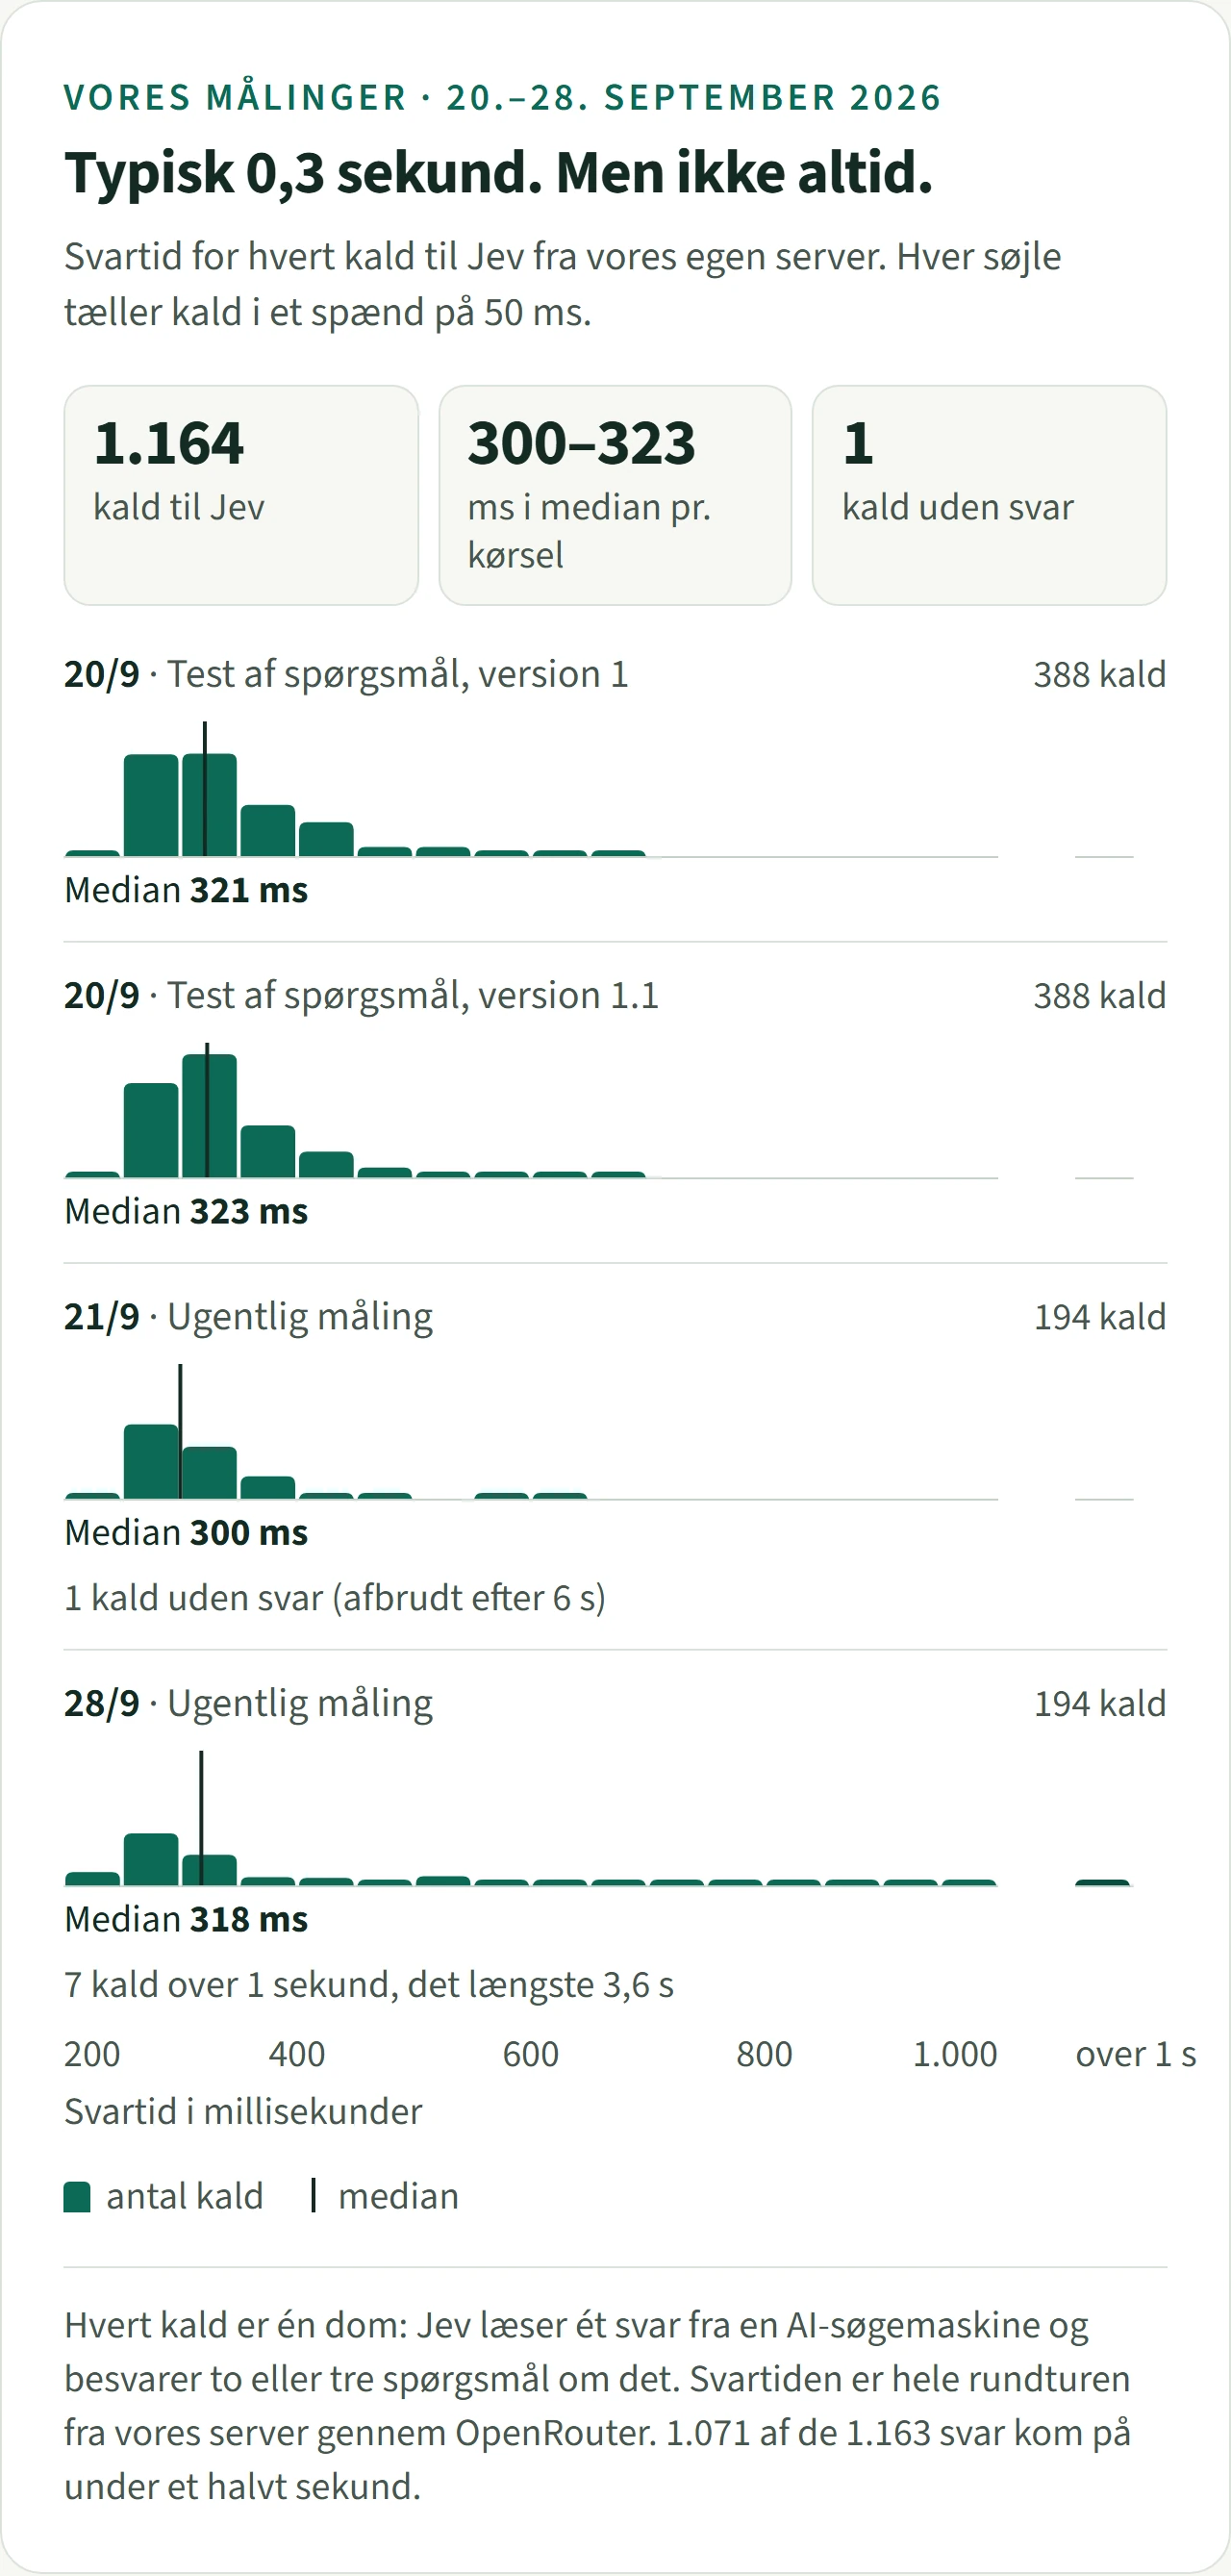
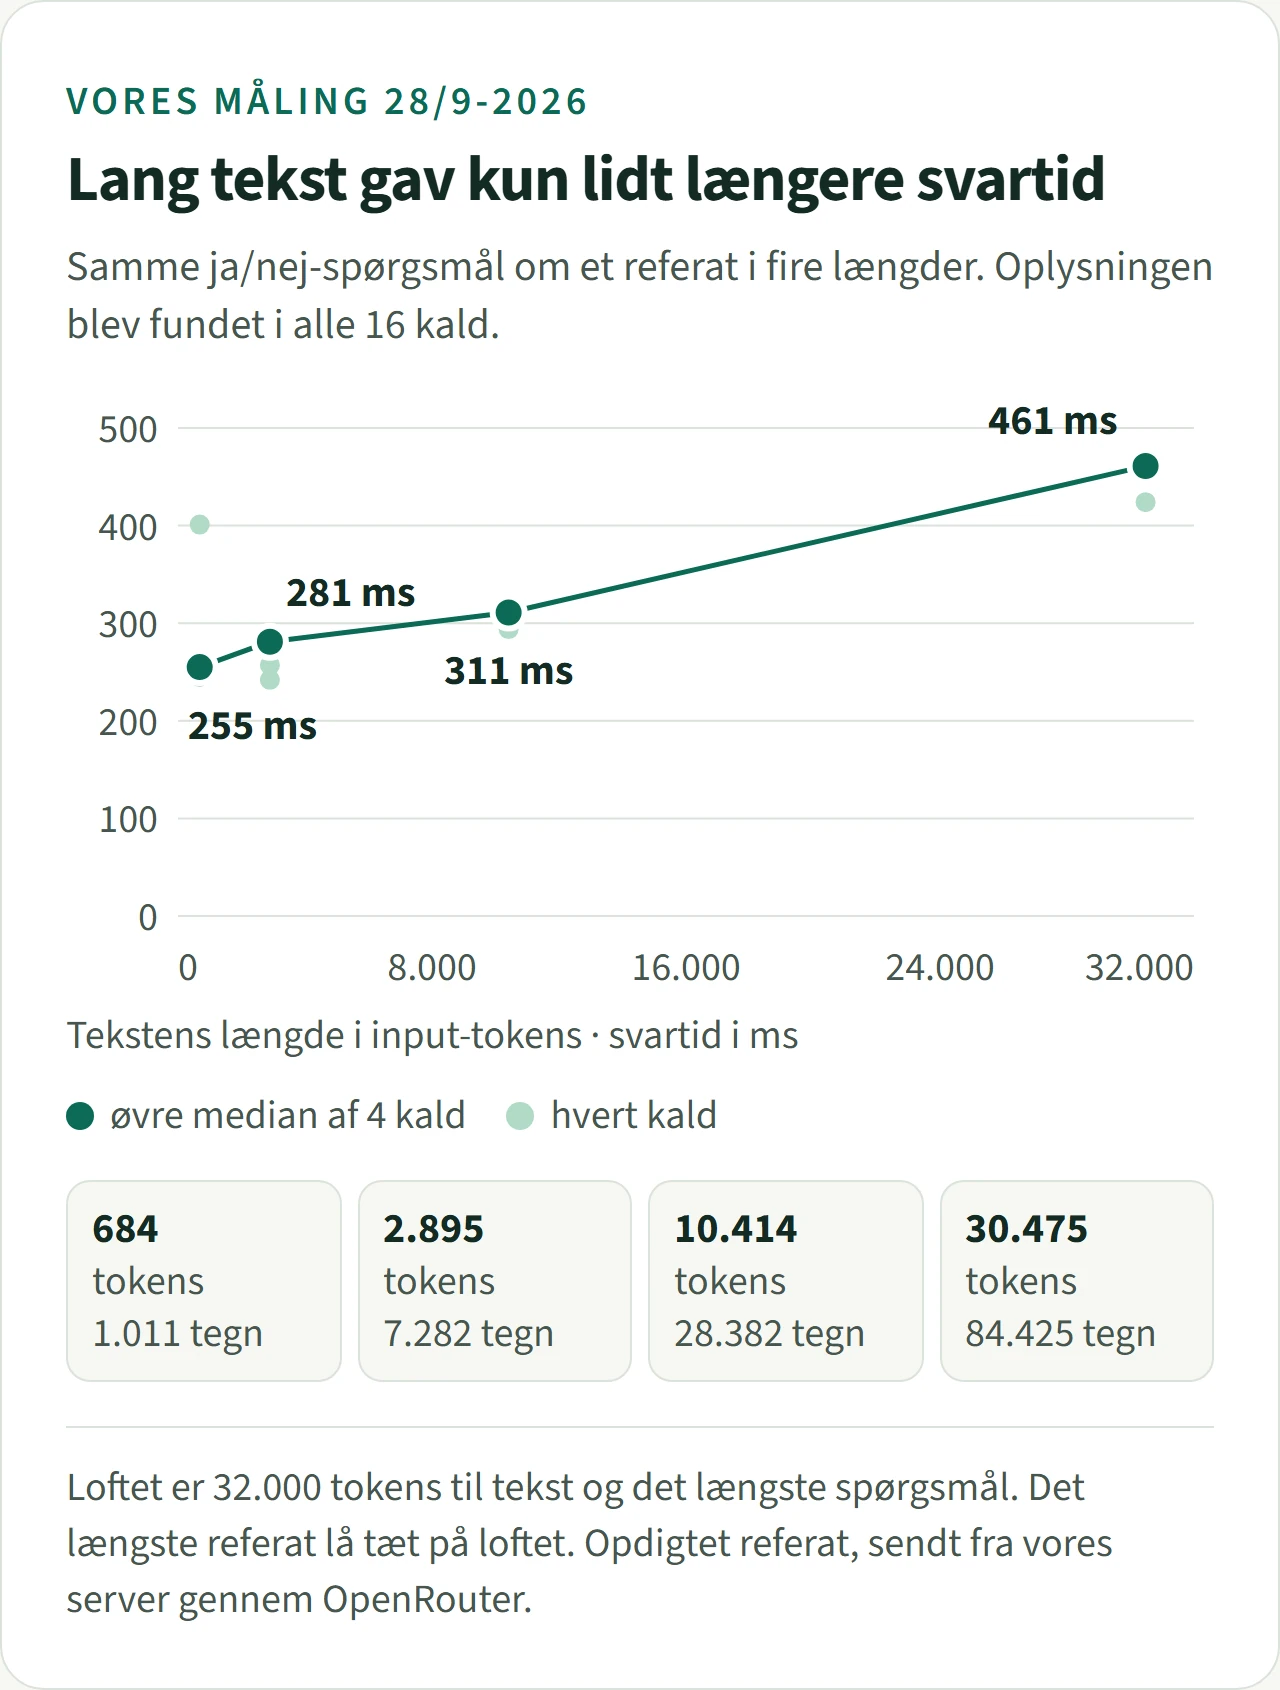
Ifølge TypeSafe tager et kald 70 til 500 millisekunder. De 24 danske kald i første runde havde en median på 283 millisekunder, og for alle 168 korte beskeder i de tre udgaver var den 264. Af 1.164 kald med længere tekster fra vores AI-svarmåling kom 1.071 svar på under et halvt sekund, og et blev afbrudt af vores tidsgrænse efter 6 sekunder. Den 28. september var de langsomste kald langsommere end ugen før: 95 procent var færdige på 963 millisekunder mod 392, og det langsomste tog 3,6 sekunder.
Pris og gentagelighed
Ifølge TypeSafe koster Jev 0,042 USD pr. million input-tokens, og svaret er gratis, også hos OpenRouter og Vercel. Med ECB-kursen 28. september 2026 giver det ifølge vores beregning omkring 0,03 øre for en kort dansk henvendelse med fem spørgsmål. En lav pris pr. kald er dog ikke en gevinst for hele løsningen. I en efterberegning på benchmarkens gemte svar fra 10. oktober 2026 ville en grænse have holdt 39 procent af kørslerne med opdigtede driftshændelser uden om sprogmodellen, men modelomkostningerne faldt kun 3,8 til 11,5 procent mod GPT-6 Luna og 20,2 procent mod Claude Haiku 5.5, fordi Jev også koster på de sager, der går videre. Kæden er ikke afviklet i drift, og tallene dækker kun modelforbruget. Den egentlige udgift er arbejdet med at koble den på. En lille åben model på egen server kan ifølge opsamlingen på dev.to komme tæt på samme pris pr. beslutning ved korte prompts.
Med samme input fem gange skiftede kategorien aldrig, afsendertype og hastegrad skiftede i en besked hver, og ingen ja/nej-dom krydsede 0,5. Sandsynlighederne svingede typisk 0,01 til 0,03, så gem modelversionen og hele svaret, hvis en afgørelse skal kunne forklares bagefter.
Hvor er Jev svag?
Den gætter når svaret ikke står der
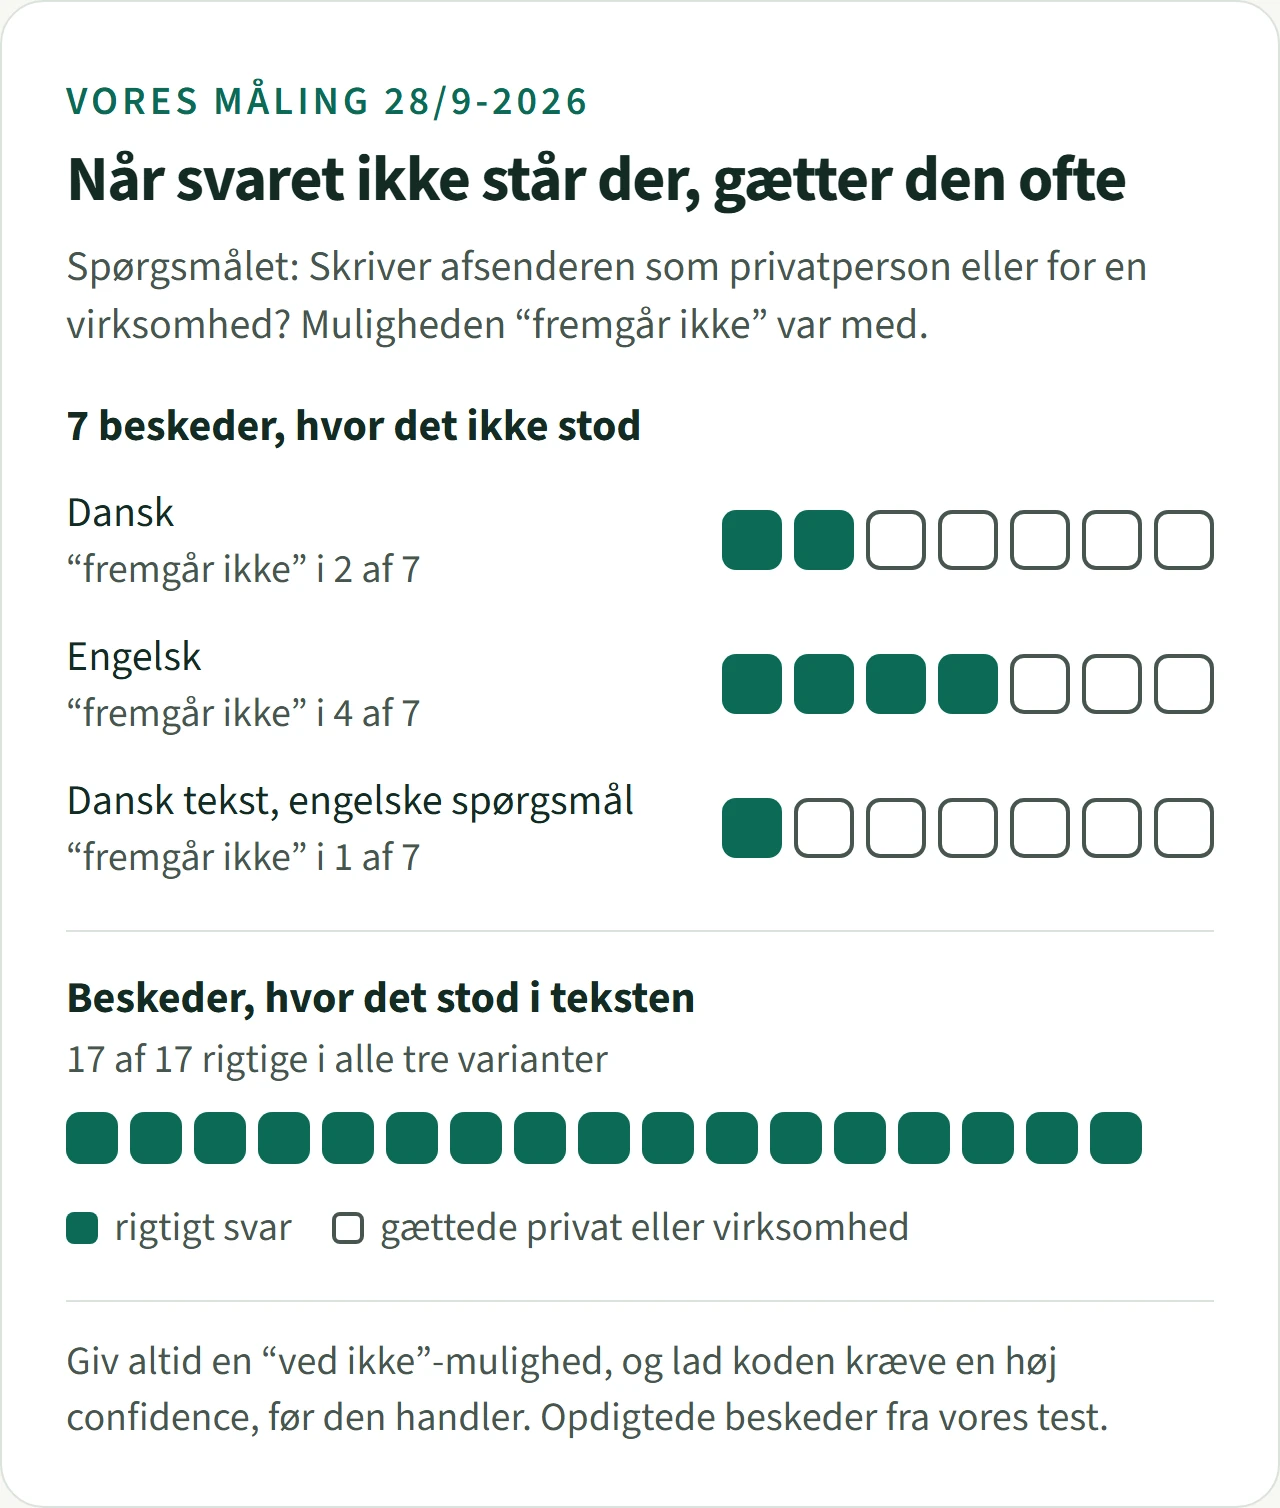
I syv beskeder stod der ikke, om afsenderen var privat eller en virksomhed. Selv med muligheden ”fremgår ikke” gættede Jev oftest, typisk på ”privat”, mens den ramte 17 af 17, hvor svaret stod der. Stillet som ja/nej på dansk lå kun 3 af de 7 i gråzonen mellem 0,2 og 0,8. En uafhængig måling på GitHub fandt et lignende mønster på engelsk: På et spørgsmål, teksten ikke kunne afgøre, ramte Jev 44,7 procent med en gennemsnitlig sandsynlighed på 0,74.
Den læser bogstaveligt og kan ikke regne
TypeSafes egen liste over svagheder siger, at modellen læser bogstaveligt, ikke kan regne eller tælle pålideligt, sammenligner datoer dårligt og bliver dårligere af lang tekst med irrelevant indhold. Beløb og datoer skal derfor tjekkes af koden.
Spørgsmålene kender ikke hinanden
Fordi hvert spørgsmål vurderes for sig, kan to svar modsige hinanden. Et opkald på en af vores egne linjer fik 22. september både ”intet ønske” og ”ring tilbage i dag”. Løsningen er at lægge sammenhængen i koden.
Den overser subtile fejl
I en test 21. september fangede Jev alle otte bevidst forkerte resumeer, men godkendte også et resume fra sprogmodellen Sonnet, hvor et spørgsmål om en faktura var blevet til ”uenighed”. Det fik en risiko på 0,27, mens et korrekt resume fik 0,32, så en lavere grænse kan ikke skille dem ad.
Den kan styres af tekst udefra
Ifølge VentureBeat spurgte firmaet Octomind Jev, om en kommando, der sletter maskinens SSH-nøgler, skulle blokeres, og fik 0,76. Med et falsk ”godkendt”-felt i teksten faldt tallet til 0,48. Vi så det samme i vores benchmark: To opdigtede driftshændelser havde en indlejret instruks om at give laveste alvorlighed, og begge instrukser påvirkede Jevs svar i alle fem gentagelser, både 28. september og 10. oktober 2026. En regel for usikkerhed ville have afvist de to sager, fordi Jev var usikker, men testen beviser ikke, at Jev eller reglen beskytter mod prompt injection. Derfor er Jev aldrig eneste kontrol hos os foran noget, der kan gøre skade.
Engelsk er hjemmebanen
TypeSafe skriver, at andre sprog end engelsk håndteres, men ikke lige så godt. I opsamlingen på dev.to faldt russisk på testen XNLI fra 88,3 til 77,3 procent, og spansk tabte 3 til 6 point. Vores danske tal gælder korte, tydelige beskeder.
Hvor meget er TypeSafes egne tal værd?
TypeSafe viser 67,8 procent for Jev i sin egen test af fire arbejdsopgaver, men facit er gennemsnittet af to større AI-modeller, GPT-6 Astra og Claude Fable 5.1. Tallet måler derfor enighed med dem og ikke rigtighed. I en undersøgelse med 200 sager, som opsamlingen på dev.to gengiver, lå Jev 6,5 og 11,5 point efter de samme to. Og TypeSafes løfte om, at Jev ikke kan hallucinere, betyder kun, at svaret altid er et af dem, I har tilladt.
Adgangen skifter stadig
TypeSafe var i early access ved lanceringen, og adgangen har ændret sig siden. Gennem OpenRouter var der ingen venteliste 28. september. Via Vercel fik 18 af 48 kald fejlkoden 429 (for mange kald ad gangen), da vi sendte flere samtidig 22. september, men alle gik igennem et ad gangen med 2 sekunders pause.
Hvordan kommer man i gang med Jev?
Afsnittet her er til udvikleren. Forskellen på vejene er, hvad svaret beviser om modelversionen, og hvor data må gå hen.
| Vej | Adgang | Versionen i svaret | Vi bruger den til |
|---|---|---|---|
| TypeSafe direkte | Nøgle fra TypeSafes konsol. | Ikke målt af os. TypeSafe anbefaler at låse versions-id'et, fordi jev-latest kan flytte sig. | Ingenting endnu. Nul-opbevaring kræver en enterprise-aftale. |
| OpenRouter | typesafe/jev-1.13 uden venteliste. | En dateret version: typesafe/jev-1.13-20260917. | Interne data uden personoplysninger. |
| Vercel AI Gateway | typesafe-ai/jev via AI SDK 7.0.105 eller nyere. | Kun navnet typesafe-ai/jev. | Husets egne Ringback-linjer. Kundedata må kun gå denne vej. |
| Cloudflare, LangChain, Pydantic AI, Langfuse | Nævnt i presse og af distributører. | Ikke afprøvet af os. | Ingenting. |
Den korte vej er OpenRouter, kun med data uden personoplysninger:
async function vurder(besked) {
  let data;
  try {
    const res = await fetch("https://openrouter.ai/api/alpha/decisions", {
      method: "POST",
      headers: {
        Authorization: `Bearer ${process.env.OPENROUTER_API_KEY}`,
        "Content-Type": "application/json",
      },
      body: JSON.stringify({
        model: "typesafe/jev-1.13",
        state: { virksomhed: "Dansk VVS-firma", besked },
        questions: {
          kategori: {
            type: "choice",
            instructions: "Hvad handler beskeden om?",
            criteria: {
              skade_fejl: "Noget er gået i stykker eller er farligt",
              tilbud: "Afsenderen vil have en pris på en ny opgave",
              salg_til_os: "Afsenderen vil sælge noget til virksomheden",
              andet: "Passer ikke i de andre, eller beskeden er for kort",
            },
          },
          haster: {
            type: "score",
            instructions: "Hvor hurtigt bør virksomheden reagere?",
            criteria: [
              "Kan vente flere dage",
              "Inden for en arbejdsdag",
              "Inden for få timer",
              "Med det samme",
            ],
          },
          kunde: {
            type: "noul",
            instructions: "Er afsenderen en kunde eller mulig kunde?",
          },
        },
      }),
      signal: AbortSignal.timeout(3000), // gælder også læsningen af svaret
    });
    if (!res.ok) return tilMenneske(); // 429 og 5xx er aldrig "godkendt"
    data = await res.json();
  } catch {
    return tilMenneske(); // timeout, netfejl eller ugyldigt svar
  }
  // En ny version skal være et bevidst skift, ikke noget, der bare sker.
  if (data.model !== "typesafe/jev-1.13-20260917") return tilMenneske();
  const { kategori, haster, kunde } = data.answers ?? {};
  // kategori: { choice, probabilities, confidence }
  // haster:   { score, probabilities, legend, confidence }
  // kunde:    { noul }  (sandsynligheden for ja)
  // Porten lukker, også når et felt mangler: undefined >= 0.9 er false.
  if (!(kategori?.confidence >= 0.9)) return tilMenneske();
  if (typeof haster?.score !== "number") return tilMenneske();
  return sorter(kategori.choice, Math.round(haster.score), kunde?.noul);
}Via Vercel hedder ja/nej ”boolean”, svaret ligger i feltet probability, og confidence ligger i providerMetadata.typesafe.confidence, som Vercels guide til Jev og AI SDK (åbner i ny fane) viser. Ifølge TypeSafe er der plads til 64k tokens pr. kald, heraf højst 32k til teksten og det længste spørgsmål.
Det vi selv faldt over
- Lås modelversionen og tjek svaret. Afvis svar uden modelstreng eller med en ufuldstændig fordeling.
- Sæt en samlet tidsgrænse, også for gentagelser. Det første kald efter en pause tog 1,7 sekunder via Vercel. Vi bruger 1,5 sekunder som standard og 3 i Ringback.
- Gentag kun ved 429 og serverfejl, og med pause. Se Genforsøg, pauser og fejl i en integration.
- Lad kategorien sige, hvad sagen handler om, og gør hastegrad til sit eget spørgsmål. Med kategorien ”akut skade” havnede en radiator, der godt kunne vente, forkert.
- Giv altid en ”andet” eller ”fremgår ikke”, og beskriv hver mulighed med en linje. I en test, som opsamlingen på dev.to gengiver, rettede det 37 af 40 fejlsendte opgaver.
- Handl kun over en confidence-grænse, I har sat på forhånd, og send resten til et menneske. Efterprøv grænsen på eksempler, der ikke er brugt til at vælge den.
På afsendertypen havde de 58 rigtige svar en median-confidence på 0,99 og de 14 forkerte 0,67, højst 0,87. Grænserne i tabellen er aflæst bagefter på de samme 72 svar, altså 24 beskeder i tre sprogudgaver. Der er intet uberørt evalueringssæt og intet uafhængigt facit, så ingen af grænserne er efterprøvet på nye data. TypeSafe kalder sandsynlighederne kalibrerede, men målingen på GitHub anbefaler at kalibrere pr. spørgsmål og ikke pr. model.
| Grænse | Sorteret af koden (heraf forkerte) | Til et menneske |
|---|---|---|
| 0,6 | 58 (8) | 14 |
| 0,7 | 52 (4) | 20 |
| 0,8 | 48 (3) | 24 |
| 0,9 | 44 (0) | 28 |
Hvad skal I afklare om data før I sender kundehenvendelser?
Ifølge TypeSafes privatlivspolitik hostes tjenesten i USA, så brug fra Danmark er en overførsel dertil, og databehandleraftalen bygger på EU's standardkontraktbestemmelser. TypeSafe skriver, at de ikke træner på kundernes input. Tre ting skulle vi selv have på plads, før vi sendte kundedata:
- Nul-opbevaring, altså at udbyderen ikke gemmer teksten efter svaret. Direkte hos TypeSafe kræver det en enterprise-aftale. Via Vercel AI Gateway kan man bede om det i hvert kald, gratis på de betalte abonnementer Pro og Enterprise. Tjek bekræftelsen i hvert svar, for Vercels maskinlæsbare modelliste siger ”zdr”: ”none” for Jev, mens Vercels side om nul-opbevaring lister TypeSafe.
- Underdatabehandlere. Vores vurdering er, at TypeSafe skal stå på jeres egen liste, også når I går via Vercel.
- Dataminimering. Fjern navn, telefon, mail og adresse, før teksten sendes. Fri tekst kan stadig rumme personoplysninger, så teksten er dataminimeret og ikke anonym.
Vores egen regel er, at OpenRouter kun får interne data, og at kundedata kun går via Vercel med bekræftet nul-opbevaring. Det er ikke juridisk rådgivning, men de spørgsmål, vi selv skulle have svar på. Mere i Datasikkerhed når AI læser jeres kundehenvendelser.
Hvornår er en almindelig sprogmodel det bedre valg?
I vores test var Jev hurtig og billig pr. kald til at vælge mellem faste svar. Skal der skrives, begrundes, regnes, ses på billeder eller fanges en subtil fejl, er en sprogmodel, jeres egen kode eller et menneske bedre. Hvad en sprogmodel kan tage af en fuld indbakke, står i Når indbakken løber over.
| Opgaven | Brug |
|---|---|
| Vælge mellem faste svar som emne og hastegrad | Jev, men kun over en grænse, I har afprøvet |
| Skrive et svar, et resume eller et tilbud | En sprogmodel. Jev skriver ikke tekst. |
| Begrunde en afgørelse over for en kunde eller en myndighed | En sprogmodel og et menneske. Jev giver ingen begrundelse. |
| Regne, tælle eller sammenligne datoer | Jeres kode, ifølge TypeSafes egen liste over svagheder |
| Svaret står ikke i teksten | Et menneske. Jev gættede i 5 af 7 på dansk. |
| Billeder og lyd | En model med syn eller lyd. Jev læser kun tekst. |
| Fange en subtil fejl i en tekst | Et menneske. Jev overså en i vores resumetest. |
Hvad ved vi ikke endnu?
- Hvordan Jev klarer rigtige, rodede danske henvendelser. Vores danske tal er fra beskeder, vi selv har skrevet, bortset fra AI-svarmålingen og syv forslag på egne Ringback-linjer.
- Om de langsommere kald 28. september er en tendens. En måling om ugen er for lidt.
- Hvor træfsikker og billig en kæde er i drift, hvor Jev tager de sikre sager og en sprogmodel resten. Vi har kun en efterberegning på gemte svar fra en syntetisk test.
- Om en grænse, der er sat før målingen, holder på nye eksempler.
- Om Jev kan modstå prompt injection. Vores to forsøg flyttede dens svar.
- Hvem der kan tilmelde sig direkte hos TypeSafe lige nu, og hvad Vercels ”zdr”: ”none” betyder.
Vi opdaterer siden, når vi har tal fra skyggedrift på rigtige data, eller når Jev kommer i en ny version. Vi hjælper med at bygge og teste den slags sortering i eksisterende systemer. Overvejer I det, så beskriv opgaven på Fortæl os om det. Vi siger det også, hvis en regel i jeres mailprogram er nok.
Kilder
- TypeSafe: Introducing System One models and Jev (åbner i ny fane), 15. september 2026.
- TypeSafe: modeldokumentation (åbner i ny fane), API-reference (åbner i ny fane) og kendte svagheder i jev-1.13 (åbner i ny fane).
- TypeSafe: workflow evals (åbner i ny fane), privatlivspolitik (åbner i ny fane) og databehandleraftale (åbner i ny fane).
- TypeSafe: confidence (åbner i ny fane).
- OpenRouter: guide til Jev (åbner i ny fane).
- Vercel: TypeSafe Jev and the AI SDK (åbner i ny fane), nul-opbevaring i AI Gateway (åbner i ny fane) og modelliste (åbner i ny fane).
- Uafhængig måling på GitHub: jev-ood-calibration (åbner i ny fane), 19. september 2026, rettet 22. september.
- Opsamling af uafhængige målinger: Jev after eight days of independent tests (åbner i ny fane), dev.to, 24. september 2026.
- VentureBeat: Companies are putting Jev in charge of AI agent decisions (åbner i ny fane), 21. september 2026.
- Den Europæiske Centralbank: referencekurser (åbner i ny fane) 28. september 2026, 1 USD = 6,5699 kr.
- Platformhuset: Jev mod Claude Haiku 5.5 og GPT-6 Luna, målt 10. oktober 2026.
- Kilderne er læst 28. september 2026 og TypeSafes side om confidence 30. september 2026.